Aggiornato il 7 novembre 2026.
Per dire no all’AI training nel robots.txt basta un gruppo di due righe: User-Agent: __usage_ai-training e Disallow: /. Esprime la preferenza che i contenuti del tuo sito non servano ad addestrare i modelli di AI, ma conta solo per i fornitori che lo leggono, e oggi non lo leggono tutti: Anthropic dice di riconoscerlo dal 30 ottobre 2026, Microsoft lo applicherà dal 1° febbraio 2027, OpenAI punta ad attivarlo nei prossimi mesi e Google dice di puntare al 2027.
Il segnale è descritto in una bozza dell’IETF del 30 ottobre 2026, firmata da Kevin Kelley di Anthropic a titolo individuale. Non è uno standard e la bozza scade il 3 maggio 2027 se non viene aggiornata. Google precisa nel suo annuncio di Google Search Central che si basa sul lavoro del gruppo AIPREF dell’IETF.
Sono Toure Tia Kevin, sviluppatore web. In questa pagina trovi cosa scrivere nel file, chi lo legge e da quando, cosa il segnale non fa e come si aggiunge su un sito WordPress.
Cosa scrivere nel robots.txt
L’esempio della bozza esprime un rifiuto per tutto il sito tranne la cartella /press-kit/, per la quale esprime invece una preferenza a favore:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
Il segnale usa la sintassi di sempre del robots.txt: la bozza non introduce nuove direttive. Il gruppo va scritto col suo nome: i gruppi User-Agent: * non valgono per questo segnale. Se nel file non c’è nessun gruppo __usage_ai-training, non è espressa alcuna preferenza.
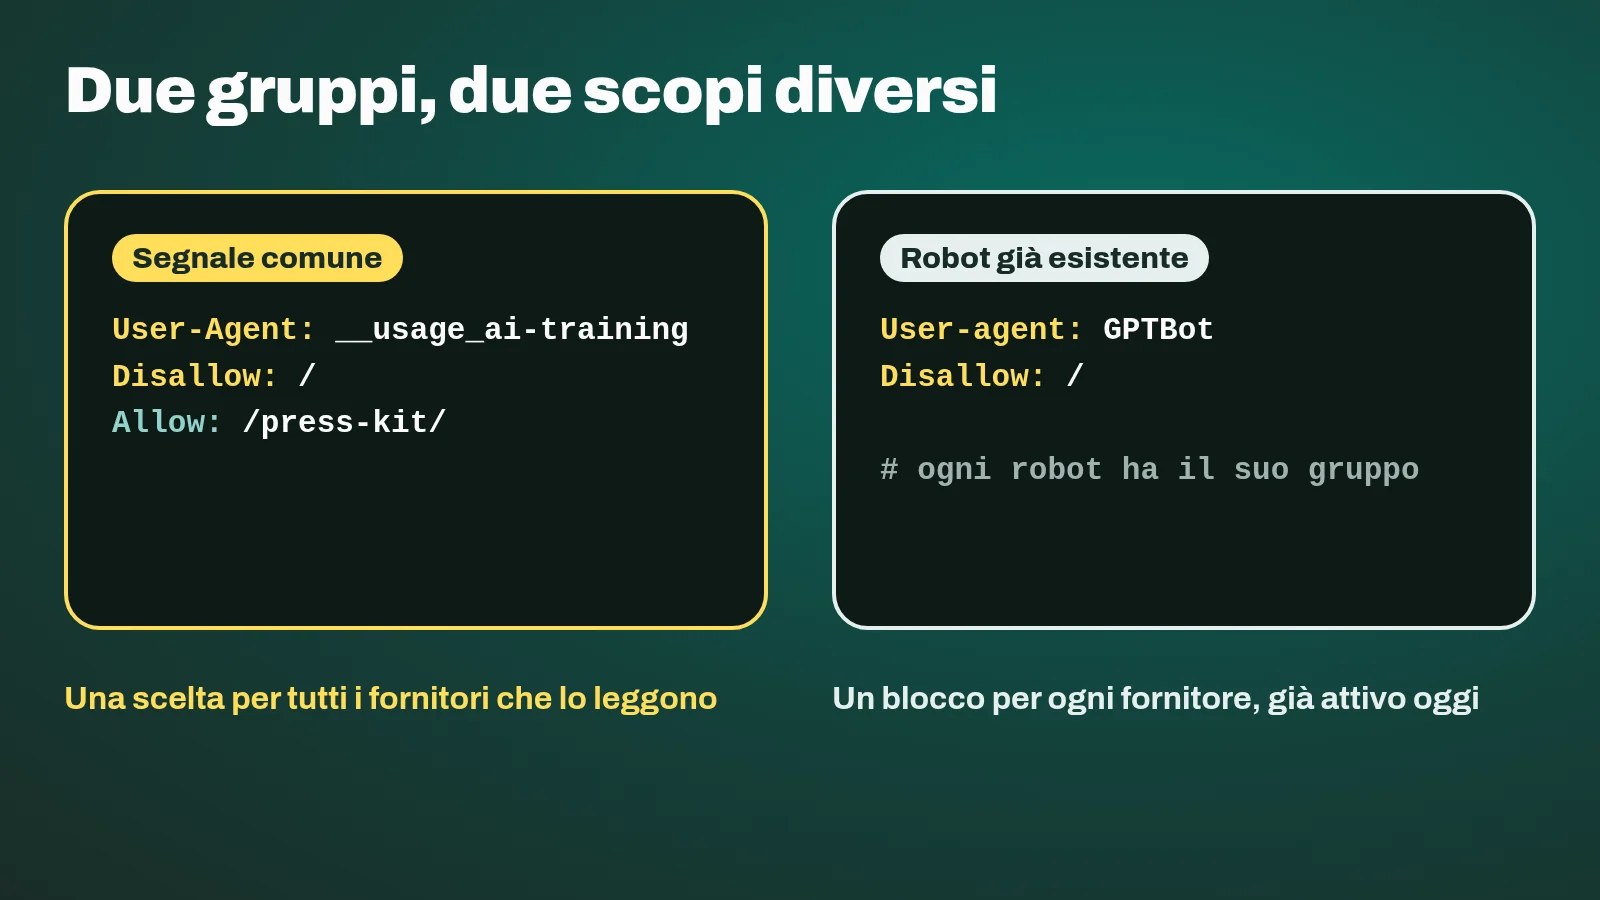
Il nuovo gruppo convive con i blocchi che hai già: la bozza dice che le due cose sono indipendenti e che i gruppi dei singoli robot continuano a significare quello che significavano. Ecco un file completo, con un sito di fantasia (è un esempio, non il file di un cliente):
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

User-agent: GPTBot
Disallow: /

User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/

Sitemap: https://www.esempio.it/sitemap.xml
In questo esempio il gruppo GPTBot blocca il robot di OpenAI che raccoglie contenuti per l’addestramento, mentre il gruppo nuovo esprime una preferenza analoga, con l’eccezione di /press-kit/, ai fornitori che lo leggeranno.
Chi lo rispetta e da quando
| Fornitore | Cosa dichiara |
|---|---|
| Anthropic | Dal 30 ottobre 2026 ha iniziato a riconoscere il segnale (pagina di assistenza di Anthropic) |
| Microsoft (Bing) | Efficace dal 1° febbraio 2027, quando il suo robot scansiona il sito (annuncio di Microsoft) |
| OpenAI | Punta ad attivarlo nei prossimi mesi, senza una data (annuncio di OpenAI) |
| Dichiara di puntare a supportarlo nel 2027, senza una data (annuncio di Google Search Central) |
Sono tempi dichiarati dalle aziende, non verificati da me: «dichiarato» non vuol dire «già attivo». Per Google la fonte primaria parla di un obiettivo (we aim to support), non di un’adesione già operativa.
Google spiega anche cosa farà: se il sito rifiuta l’addestramento col segnale comune e non nomina Google-Extended, Google prevede di interpretarlo come se il sito avesse bloccato Google-Extended. I controlli esistenti continuano a funzionare accanto al segnale. Microsoft aggiunge una scadenza: chi usava i tag NoArchive e NoCache per esprimere queste preferenze deve pubblicare la nuova preferenza entro il 1° marzo 2027: per l’addestramento nel robots.txt o nelle singole pagine, per l’uso dei contenuti nelle risposte solo nelle pagine (con una preferenza temporanea in Bing Webmaster Tools). Dopo quella data quei tag non saranno più letti come preferenza né per l’una né per l’altra cosa.
Cosa non fa
- Non è un blocco della scansione. La bozza lo dice chiaramente: il segnale non è una direttiva per la scansione, esprime una preferenza sull’uso dei contenuti. Per limitare l’accesso di un robot servono i gruppi con il nome di quel robot.
- Non ha effetto su chi non lo legge ancora. Un robot che non lo conosce ignora il gruppo, come ignora il gruppo di qualsiasi robot che non riconosce. Aggiungerlo oggi non cambia nulla per i fornitori che non lo hanno ancora attivato.
- Non protegge i contenuti riservati. Il robots.txt è un file pubblico e il segnale è una preferenza: ciò che non deve circolare va dietro un login. Per la protezione del sito leggi la guida su come mettere in sicurezza un sito WordPress.
- Non toglie il sito dai risultati di ricerca. Microsoft scrive che le preferenze non cambiano l’idoneità ai risultati tradizionali di Bing, salvo i normali requisiti di scansione e indicizzazione; per Google,
Google-Extendednon influisce sull’inclusione nella Ricerca né è un segnale di posizionamento. - Può essere superato da accordi privati: la bozza prevede che accordi privati possano prevalere sulle preferenze espresse in questo modo.
Robot che addestrano e robot che rispondono
Il segnale riguarda l’addestramento. Molti robot dei fornitori di AI servono ad altro, e la documentazione dei fornitori li distingue. Per OpenAI, GPTBot raccoglie contenuti che possono servire all’addestramento, OAI-SearchBot serve a mostrare i siti nelle ricerche di ChatGPT e ChatGPT-User agisce quando un utente lo chiede; per quest’ultimo, scrive OpenAI, le regole del robots.txt potrebbero non valere (documentazione dei robot di OpenAI). Anthropic elenca ClaudeBot, che raccoglie contenuti per migliorare i modelli generativi, Claude-User per le richieste degli utenti e Claude-SearchBot per la qualità della ricerca (pagina di assistenza di Anthropic).
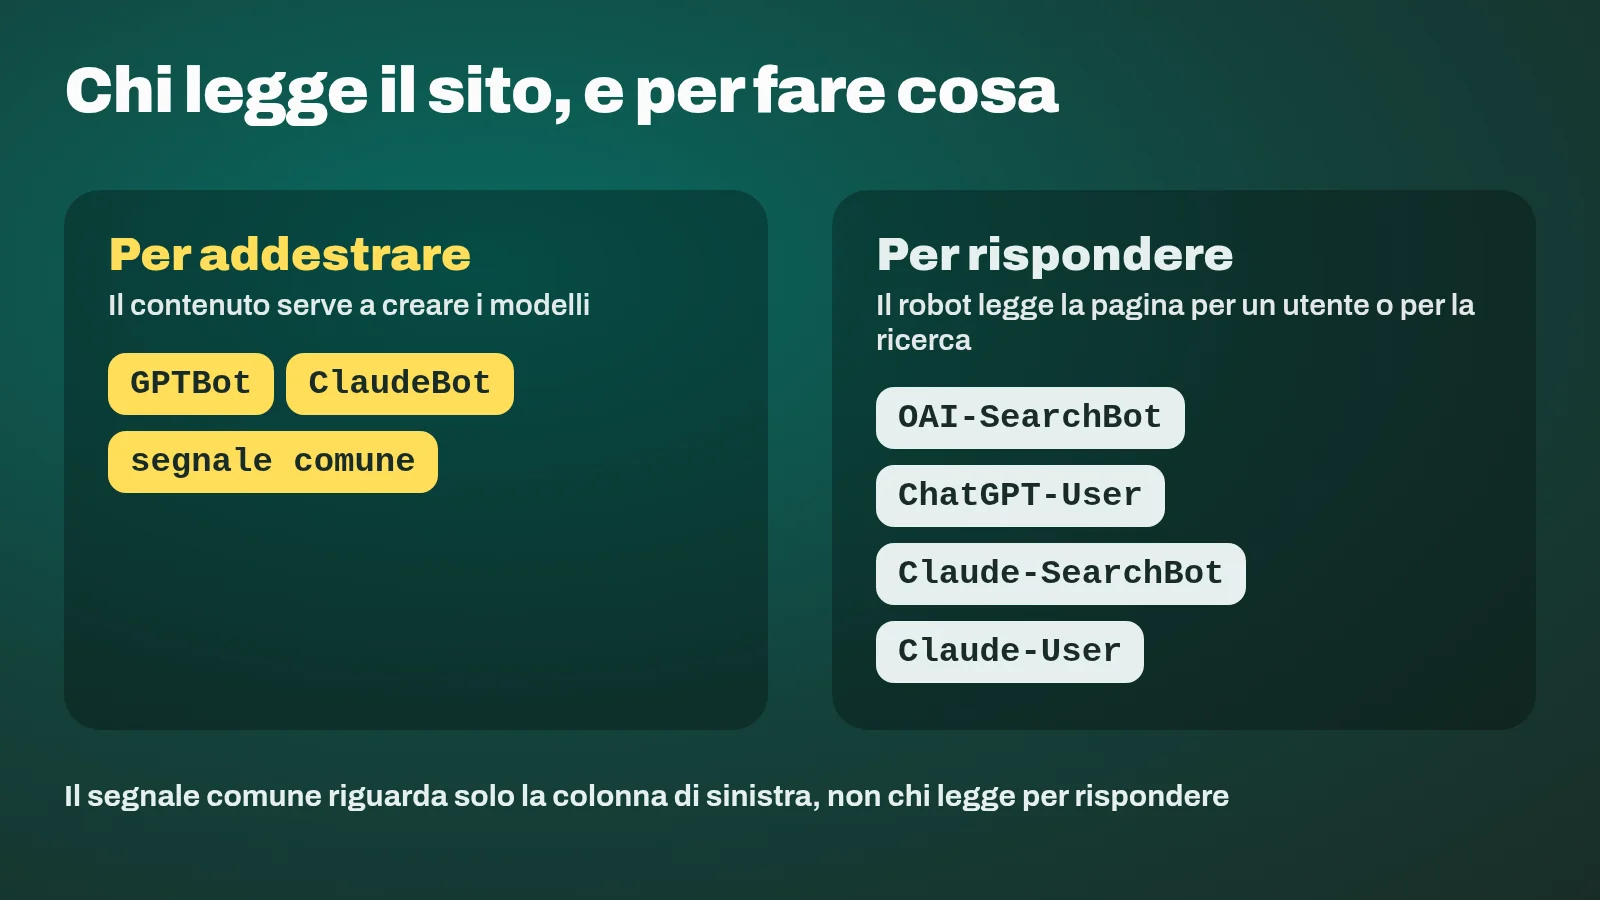
La conseguenza pratica: rifiutare l’addestramento col nuovo segnale non ti toglie dalle risposte di ChatGPT, mentre bloccare OAI-SearchBot sì, perché per OpenAI i siti che lo rifiutano non vengono mostrati nelle risposte della ricerca di ChatGPT, anche se possono comparire come link di navigazione. Sono scelte diverse, e conviene farle una per una. Per come si compare nelle risposte di Google trovi un altro articolo: come far comparire il tuo sito in AI Overviews e AI Mode. Per capire poi se le visite da ChatGPT arrivano al tuo sito, c’è la guida su come vedere il traffico di ChatGPT in Google Analytics 4.
Quando conviene bloccare e quando no
Questa parte è una mia valutazione, non un dato delle fonti. Il segnale si può dare per cartella, quindi la domanda utile non è «blocco tutto o niente?», ma «quali pagine sono il mio prodotto e quali sono la mia vetrina?».
- Conviene rifiutare l’addestramento sulle pagine che sono il tuo prodotto: materiali di formazione, documentazione tecnica a cui lavori da anni, banche dati o listini pubblici che altri potrebbero riusare.
- Conviene lasciare libere le pagine che vuoi far conoscere: servizi, comunicati, schede dei prodotti. Google scrive che i siti che consentono espressamente
Google-Extendedpossono comparire nelle risposte di Gemini e ricevere clic. - Esempio (inventato): un’impresa che vende un corso online potrebbe rifiutare l’addestramento su
/corso/, dove sta il materiale a pagamento, e lasciarlo libero su/blog/.
Se vuoi un parere sul tuo sito, qui trovi come lavoro con la consulenza SEO per le imprese e con l’intelligenza artificiale per le aziende. Un altro caso in cui l’AI cambia da dove arrivano le visite è quello dell’e-commerce, nell’articolo su il traffico che arriva dall’AI e le conversioni nello studio Adobe.
Per i dati italiani su chi usa l’AI per comprare, e cosa può fare un negozio, c’è Acquisti con l’AI in Italia: cosa cambia per i negozi.
Come farlo su un sito WordPress
- Apri
tuosito.it/robots.txtnel browser e copia il contenuto in un file di testo: è la tua copia di sicurezza. - Controlla se ci sono già gruppi per
GPTBot,ClaudeBotoGoogle-Extended: restano validi e non vanno toccati. Anthropic scrive che una regola che nominaClaudeBotha la precedenza sul segnale generale. - Decidi per cartella cosa rifiutare e cosa consentire, e annotalo prima di modificare il file.
- Aggiungi il gruppo. Con Rank Math si fa da Rank Math SEO, Impostazioni generali, Modifica robots.txt (serve la modalità avanzata attiva). Rank Math crea un file virtuale: se sul server esiste già un file
robots.txtvero, le modifiche fatte dal plugin non hanno effetto, come spiega la guida di Rank Math al robots.txt. Con un altro plugin o con un sito su misura, chiedi a chi lo cura. - Salva, riapri
tuosito.it/robots.txte controlla che il gruppo sia scritto per intero, con il nome__usage_ai-trainingsenza errori. - Segna una data a fine gennaio 2027, prima del 1° febbraio, e una ogni volta che la bozza cambia stato: i tempi sono dichiarati dalle aziende e possono cambiare.
Domande frequenti
Se non faccio nulla, i miei contenuti possono essere usati per addestrare l’AI?
Se nel file non c’è il gruppo __usage_ai-training, il segnale non esprime alcuna preferenza: la bozza dice che non è espressa alcuna preferenza, e Microsoft precisa che il consenso è il valore predefinito, quindi non serve alcuna impostazione per consentire l’addestramento. I blocchi che hai già su singoli robot, come GPTBot, restano validi. Non è un parere legale: dice solo cosa comunica il file.
La riga nel robots.txt fa sparire il mio sito da Google o da Bing?
No, secondo le fonti primarie. Microsoft scrive che le preferenze non cambiano l’idoneità ai risultati tradizionali di Bing, e Google scrive che Google-Extended non influisce sull’inclusione né sul posizionamento nella Ricerca.
Questa regola vale già oggi per tutte le aziende AI?
No. È una bozza individuale e i tempi sono diversi: Anthropic dice di riconoscerla dal 30 ottobre 2026, Microsoft dal 1° febbraio 2027, OpenAI punta ai prossimi mesi e Google al 2027. Le fonti che ho letto non contengono indicazioni specifiche sull’Italia.
Cosa succede se uso il segnale e non nomino Google-Extended?
Google dichiara che, in quel caso, prevede di interpretare il rifiuto come se avessi bloccato Google-Extended. Se vuoi consentire Google-Extended mentre rifiuti l’addestramento agli altri, per quanto dichiara Google devi nominarlo: la condizione che indica è che Google-Extended non sia specificato.
Fonti
Lette il 7 novembre 2026. La pagina di assistenza di Anthropic non nomina il token: dice che dal 30 ottobre 2026 Anthropic riconosce un segnale leggibile dalle macchine, basato su una bozza dell’IETF.
- Google Search Central Blog, «Supporting a shared AI training control for websites» (30 ottobre 2026)
- IETF, bozza «Machine-Readable Training Preference Signal», draft-kelley-aipref-training-preference-signal-00 (30 ottobre 2026)
- Microsoft Bing Blogs, «Your content, your choice: clearer preferences for training and grounding» (30 ottobre 2026)
- OpenAI, «Making it easier for websites to express AI training preferences»
- OpenAI, documentazione dei robot (GPTBot, OAI-SearchBot, ChatGPT-User)
- Anthropic, assistenza: «Does Anthropic crawl data from the web, and how can site owners block the crawler?»
- Google Search Central, documentazione dei crawler comuni (Google-Extended)
- Rank Math, guida «Using Rank Math’s Robots.txt Generator»
Testo preparato con l’AI e verificato sulle fonti indicate. L’avatar di Kevin nelle immagini è generato con l’AI.